Hei,
Edellisessä blogissa kirjoitin data-alan AI-paradoksista. Teknologia kehittyy nyt todella nopeasti. SQL kirjoittamista, pipelinejen rakentamista, dashboardeja ja jopa semanttisia malleja pystytään automatisoimaan yhä enemmän. Samalla AI hyödyntämisessä törmätään kuitenkin koko ajan samaan ongelmaan: tekoäly ei tarvitse vain dataa, vaan sen pitää ymmärtää, mitä data tarkoittaa.
Mikä on asiakas? Mitä tarkoittaa aktiivinen asiakas? Miten churn lasketaan? Kuka omistaa määritelmän? Mikä KPI on virallinen?
Edellisessä kirjoituksessa pohdin sitä, miten datatiimi pystyy ratkaisemaan tämän, jos sillä on mandaatti rakentaa teknologiaa, mutta ei välttämättä mandaattia vaikuttaa liiketoiminnan prosesseihin, omistajuuksiin ja toimintamalleihin.
Tässä kirjoituksessa haluan mennä yhden askeleen pidemmälle ja miettiä, miten tällainen “Company Brain” pitäisi käytännössä rakentaa.
Tässä kirjoituksessa käytän termiä Company Brain kuvaamaan kokonaisuutta, jossa organisaation data, yhteiset käsitteet, KPI, dokumentaatio ja muu liiketoimintakonteksti on järjestetty niin, että myös AI pystyy käyttämään sitä luotettavasti.
Mutta siihen kuuluu myös paljon sellaista tietoa, jota ei tänä päivänä löydy yhdestäkään järjestelmästä. Yrityksissä on valtava määrä hiljaista tietoa, joka elää ihmisten päissä, organisaation kulttuurissa, Teams-keskusteluissa, sähköposteissa, kokouksissa ja joskus ihan lounaspöydässä.
Ihmiset tietävät esimerkiksi, että “tuota lukua ei oikeastaan kannata käyttää tähän”, “tämän asiakkaan kanssa toimitaan vähän eri tavalla” tai “tämä määritelmä muutettiin viime keväänä, vaikka dokumentaatiossa lukee vielä vanha”.
Kaikkea tällaista hiljaista tietoa ei tietenkään tarvitse tai edes pidä saada AI käyttöön. Mutta jos AI halutaan ymmärtävän yrityksen toimintaa nykyistä paremmin, ainakin tärkeä osa tästä tiedosta pitäisi pystyä muuttamaan eksplisiittiseksi, hallituksi ja ylläpidettäväksi kontekstiksi.
Oma lähtökohtani on aika yksinkertainen: Company Brainia ei pitäisi yrittää rakentaa jälkikäteen dokumentoimalla jo syntynyttä ympäristöä, vaan sen pitäisi syntyä osana normaalia tekemistä, domain kerrallaan.
Governancea lähemmäs datan syntyä
Tätä ei tule aina ajatelleeksi, jos on itse data-alan kuplassa, kuten minä ja moni muu. Eräs data-alalle vasta tullut esitti minulle kerran mielenkiintoisen huomion.
Data-alalla on vähän kummallinen toimintamalli.
Kun rakennetaan data-alustaa, painotetaan aivan ymmärrettävästi nopeutta, kustannustehokkuutta ja agilea tekemistä. Ei haluta mallintaa liikaa etukäteen, tehdä ylimääräistä dokumentaatiota tai käyttää aikaa asioihin, joista asiakas ei koe saavansa heti näkyvää hyötyä.
Tässä on paljon järkeä. En itsekään kaipaa takaisin maailmaan, jossa ennen ensimmäistäkään toteutusta tehdään vuoden enterprise architecture- tai MDM-harjoitus.
Mutta minusta Data Governancen painopiste on monessa organisaatiossa edelleen aika pitkällä datan elinkaaren loppupäässä. Governance näkyy vahvasti data-alustan, analytiikan, raportoinnin ja data catalogin ympärillä. Siellä aletaan sitten selvittää, mitä data tarkoittaa, kuka sen omistaa, kuinka laadukasta se on ja mihin sitä saa käyttää.
Ongelma on, että tässä vaiheessa data on voinut kulkea jo pitkän matkan.
Jos tieto asiakkaasta syntyy CRMä, tuotteesta operatiivisessa järjestelmässä tai työntekijästä HR-järjestelmässä, olisi aika luontevaa, että ainakin osa sen merkityksestä, omistajuudesta, laatukriteereistä ja käyttöön liittyvistä säännöistä syntyisi mahdollisimman lähellä tätä kohtaa.
Tästä puhutaan usein nimellä shift left governance.
Ajatus ei ole, että kaikki governance pitäisi tunkea operatiivisiin järjestelmiin tai että jokaiselle kentälle pitäisi rakentaa raskas hyväksyntäprosessi. Pointti on pikemminkin siinä, ettei kaikkea merkitystä, laatua ja vastuuta pitäisi joutua rekonstruoimaan vasta siinä vaiheessa, kun data on päätynyt analytiikkaan tai raportointiin.
Minusta governance pitäisi nähdä enemmän datan mukana kulkevana ominaisuutena kuin erillisenä loppupään toimintona.
Jos merkitys, omistajuus ja laatu syntyvät siellä missä datakin syntyy, niiden pitäisi kulkea datan mukana data-alustalle, datatuotteisiin, raportointiin ja lopulta AI-agenttien käyttöön.
Ehkä tätä voisi verrata ohjelmistokehityksen testaukseen. Aikaisemmin testaus saattoi tapahtua erillisenä vaiheena kehityksen lopussa. Modernissa ohjelmistokehityksessä testausta tehdään jatkuvasti jo rakentamisen aikana. Data Governancen pitäisi minusta liikkua samaan suuntaan.
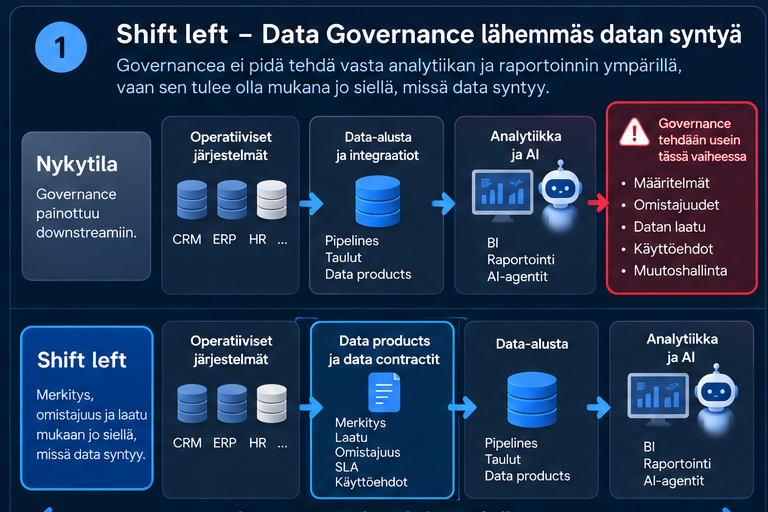
Kuva 1. Shift left – Data Governance lähemmäs datan syntyä.
Data product -ajattelu kannattaa
Jos rakennetaan uusi data product, Conversational BI -ratkaisu tai AI-agentti, samalla pitäisi syntyä ainakin osa sen tarvitsemasta kontekstista. Mitä käsitteitä tässä käytetään? Miten tärkeät KPI lasketaan? Kuka ne omistaa? Mitkä suhteet ovat olennaisia? Mikä on virallinen määritelmä ja mikä taas vain tämän yhden tiimin käyttämä paikallinen termi?
Ajatus ei ole, että jokaisesta uudesta taulusta käynnistetään governance-ohjelma. Päinvastoin. Governancen pitäisi olla niin lähellä normaalia tekemistä, ettei sitä tarvitse rakentaa myöhemmin erillisenä projektina.
Jos joku muistaa vielä Data Meshin ja data productit, niin tämän pitäisi kuulostaa aika tutulta.
Data product -ajattelu on minusta tässä järkevää. Data nähdään tuotteena, jolla on kuluttaja, joka antaa siitä palautetta ja jonka tarpeiden mukaan tuotetta kehitetään eteenpäin.
Tämä tekee muutoksistakin hallittavampia. Jos esimerkiksi datan rakenne muuttuu tavalla, joka rikkoisi nykyisiä käyttötapauksia, muutosta ei vain työnnetä kaikille kerralla, vaan siitä voidaan tehdä uusi versio ja antaa kuluttajille aikaa siirtyä siihen hallitusti.
Myös data contractit vievät samaan suuntaan, koska niiden avulla datalle syntyy lisää kontekstia. Data contract on datan tuottajan ja käyttäjien välinen sovittu kuvaus datan sisällöstä, rakenteesta, laadusta, omistajuudesta, käyttöehdoista, palvelutasosta ja siitä, miten muutoksista sovitaan.
Siinä voidaan siis määritellä esimerkiksi, mitä data sisältää, missä muodossa se tulee, millaisia laatuvaatimuksia siihen liittyy, kuka sen omistaa, mikä on sen SLA tai päivitystiheys, kenellä on siihen käyttöoikeus ja miten muutokset kommunikoidaan.
Kaikki tämän tyyppiset prosessit vievät meitä minusta oikeaan suuntaan.
Kuten edellisessä blogissa kirjoitin, keskitetty service desk -malli, jossa liiketoiminta lähettää tiketin datatiimille ja odottaa lopputulosta, ei oikein tue tätä. Jos semanttisen kerroksen pitäisi elää liiketoiminnan mukana, myös palautteen, muutosten ja määritelmien pitäisi kulkea jatkuvasti molempiin suuntiin.

Kuva 2. Data product, data contract ja jatkuva palaute.
Federated ownership, shared meaning
Minusta hyvä malli tähän on federated-ajattelu tai jo vähän terminä muodista pois mennyt Data Mesh. Domain omistaa oman maailmansa ja saa käyttää omaa kieltään. Kaikkea ei tarvitse standardoida koko yrityksen tasolla.
Markkinoinnilla voi olla omat käsitteensä, myynnillä omansa, taloudella omansa ja HR:llä omansa. Jos esimerkiksi markkinoinnilla on oma kampanjaluokitus, jota kukaan muu ei käytä, sen ei tarvitse päätyä mihinkään enterprise-ontologiaan.
Osa käsitteistä kuitenkin ylittää domainien rajat. Asiakas on tästä ilmeinen esimerkki. Sama asiakas näkyy myynnissä, markkinoinnissa, laskutuksessa, asiakaspalvelussa ja analytiikassa. Silloin tarvitaan yhteistä ymmärrystä siitä, mitä käsitteellä tarkoitetaan, miten se liittyy muihin käsitteisiin ja mikä määritelmä on organisaatiossa yhteinen.
Sama koskee mittareita. Markkinointi voi käyttää kymmeniä omia KPIä, mutta jos sama mittari näkyy myynnissä, taloudessa, johtoryhmän raportoinnissa ja AI-agentin vastauksissa, sen määritelmän pitäisi olla yhteinen.
Kun joku käsite, KPI tai ydinentiteetti muuttuu laajemmin merkitykselliseksi, se voidaan nostaa eli tavallaan promotoida yhteiseen enterprise-malliin. Omistajuuden ei silti tarvitse siirtyä pois domainilta.
Kaikkea ei myöskään tarvitse väkisin yhdenmukaistaa. Synonyymeillä voidaan kuvata eri sanoja samalle asialle, ja homonyymeillä samaa sanaa, jolla on eri merkitys eri yhteyksissä.
Esimerkiksi myynti voi puhua asiakkaasta termillä Account, kun taas kirjanpidossa sama sana voi tarkoittaa jotain aivan muuta. Pääasia ei ole, että kaikki käyttävät aina samaa sanaa, vaan että tiedämme ja dokumentoimme, mitä kukin termi missäkin domainissa tarkoittaa.
Tässä on federated-mallin yksi hienous: yhteistä semanttista mallia ei tarvitse rakentaa yhtenä isona harjoituksena. Se syntyy vähitellen, vähän kuin tilkkutäkki, pala palalta, kun eri domainien käsitteitä ja merkityksiä liitetään yhteen ja vain tarvittavat asiat nostetaan yhteiselle tasolle.
Jos markkinointi todella on oikea taho omistamaan tietyn asiakkuuteen liittyvän määritelmän, se voi omistaa sen edelleen. Yhteinen malli kertoo vain, että tämä on organisaation virallinen määritelmä ja tätä muutkin käyttävät.
Voisi sanoa hienosti englanniksi: federated ownership, shared meaning.
Eri domainit säilyttävät omistajuuden omasta maailmastaan, mutta yhteiset määritelmät, suhteet ja tunnisteet sitovat kokonaisuuden yhteen.
Minusta tässä on Company Brainin yksi tärkeimmistä periaatteista. Kaikkea ei tarvitse keskittää, mutta merkityksen pitää yhdistyä.

Kuva 3. Federated-malli: domainit saavat käyttää omaa kieltään, mutta yhteiset käsitteet yhdistetään.
Don’t boil the ocean
Tässä kohtaa tulee toinen tärkeä periaate: koko organisaation täydellistä Enterprise Data Modelia tai ontologiaa ei kannata yrittää rakentaa yhdellä kertaa.
Don’t try to boil the ocean.
Aloita yhdestä käsitteestä, josta ihmiset oikeasti ovat eri mieltä. Sopikaa sen merkitys, liittäkää se käsitemalliin ja suhteisiin, määritelkää tarvittavat mittarit ja viekää tämä osaksi käytännön toteutusta.
Jos tavoitteena on esimerkiksi rakentaa Conversational BI asiakaspoistuman analysointiin, mallinnetaan ensin juuri siihen tarvittavat käsitteet, KPI, suhteet ja omistajuudet. Sitten katsotaan yhtä askelta pidemmälle: mitkä näistä ovat vain tämän casen asioita, mitkä kuuluvat domainille ja mitkä pitäisi nostaa koko organisaation yhteiseen malliin?
Yksi case kerrallaan yhteinen malli alkaa kasvaa modulaarisesti. Samalla jokainen projekti tuottaa heti liiketoiminta-arvoa eikä vain rakenna tulevaisuutta varten abstraktia mallia.
Databricksin Senior Delivery Solutions Architect Prashanth Subrahmanyam kuvaa tuoreessa kirjoituksessaan käytännössä hyvin samanlaista etenemistä Genie Ontologyn kanssa. Aloita yhdestä domainista, rakenna kunnollinen datamalli, määritä hallitut KPI Metric Viewsiin, pilotoi agenttia oikeilla kysymyksillä, nimeä business- ja technical ownerit ja laajenna vasta sitten seuraavaan domainiin.
Hänen suosituksensa on nimenomaan kasvattaa kokonaisuutta domain kerrallaan.
Minusta tämä on paljon realistisempi tapa rakentaa Company Brainia kuin massiivinen top-down-ohjelma: ratkaistaan oikea ongelma ja samalla sovitaan muutama asia kunnolla. Sitten seuraava case.
Mutta kuka huolehtii yhteisestä merkityksestä?
Federated-mallissa tulee vastaan yksi ilmeinen ongelma. Jos kaikki omistavat omat käsitteensä, kuka katsoo kokonaisuutta?
Kuka huomaa, että markkinointi ja talous käyttävät sanaa “aktiivinen asiakas” eri tavalla? Kuka koordinoi muutoksen, jos yksi määritelmä vaikuttaa kymmeneen dashboardiin ja kolmeen AI-agenttiin?
Tästä voisi käyttää termiä Semantic Steward. En ole varma, tarvitseeko jokaisen organisaation palkata henkilö juuri tällä tittelillä, mutta rooli tarvitaan.
Domain tai Data Owner omistaa edelleen määritelmän liiketoiminnallisesti. Semantic Stewardin kaltainen rooli auttaa varmistamaan, että yhteiset määritelmät ovat johdonmukaisia, versioituja ja käytössä siellä missä niiden pitää olla.
Eli yksinkertaistettuna: domain omistaa, Semantic Steward koordinoi ja federated enterprise model kertoo, mikä on yhteistä ja virallista.
AI voi auttaa tekemään governancesta vähemmän raskasta
Perinteisen governancen ongelma on, että se koetaan helposti lisätyöksi. Pidetään taas uusi workshop, täytetään taas uusi dokumentti ja päivitetään taas data catalog.
Mitä jos AI tekisi osan tästä työstä?
Suuri osa yrityksen todellisesta kontekstista elää jo nyt Teamsissa, sähköposteissa, kokouksissa, PowerPointeissa, dokumenteissa ja ihmisten päässä. AI pystyy jo käyttämään osaa tällaisesta materiaalista kontekstina.
Ajatellaan taas esimerkkiä aktiivisesta asiakkaasta. Markkinointi keskustelee Teamsissa ja päättää muuttaa määritelmän kuudesta kuukaudesta 12 kuukauteen. Nykyisessä mallissa jonkun pitäisi muistaa päivittää dokumentaatio, semanttinen kerros ja ehkä tehdä tiketti datatiimille.
Tulevaisuudessa AI voisi huomata keskustelusta, että aktiivisen asiakkaan määritelmä näyttää olevan muuttumassa, ja ehdottaa virallisen määritelmän päivittämistä.
Tässä AI ei päätä, mikä on totta. Se auttaa havaitsemaan mahdollisen muutoksen, ja oikea omistaja hyväksyy sen.
Tämä olisi minusta paljon kiinnostavampi tulevaisuus kuin se, että lisäämme vain enemmän governance-lomakkeita.
Tästä löytyy muuten jo kiinnostavia käytännön esimerkkejä. Meta kuvaa omassa Engineering-blogissaan ratkaisua nimeltä “Organizational Second Brain”. Heidän lähtökohtansa on hyvin samanlainen: suuri osa organisaation arvokkaimmasta asiantuntijatiedosta elää ihmisten päässä eikä päädy koskaan pysyvään muotoon.
Metan ratkaisussa tätä hiljaista asiantuntijatietoa muutetaan rakenteiseen ja auditoitavaan tietopohjaan. Erityisen kiinnostavaa on se, että he erottavat toisistaan sen, mitä agentti tietää ja miten agentti päättelee. Asiantuntijoiden tekemät korjaukset voidaan lisäksi viedä takaisin yhteiseen tietopohjaan hallittuina ja testattuina muutoksina.
Eli parhaimmillaan yhden asiantuntijan tekemä korjaus ei jää vain yhteen keskusteluun, vaan siitä voi tulla osa organisaation pysyvää muistia.
Tämä on minusta aika lähellä sitä, mitä tässä tarkoitan Company Brainilla.
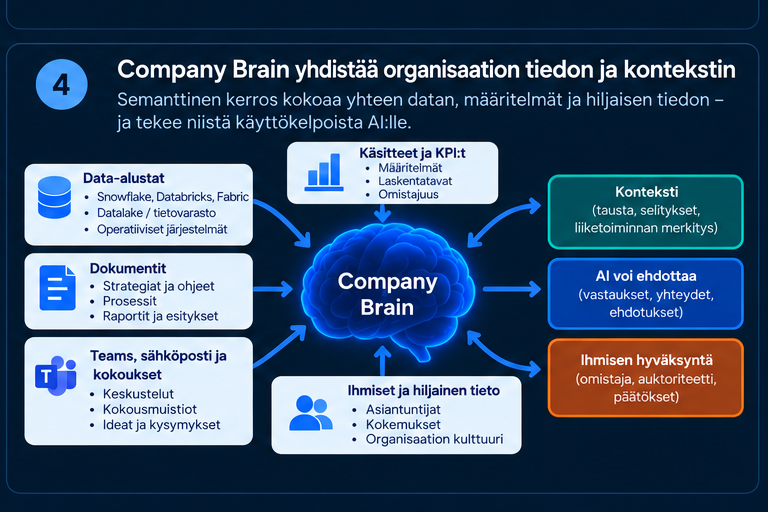
Kuva 4. Company Brain yhdistää datan, määritelmät ja liiketoiminnan kontekstin.
Mutta kaikkea ei voi vain syöttää tekoälylle
Tähän liittyy kuitenkin toinen iso riski.
Joe Reis kirjoitti Big Data Londonin jälkeen osuvasti Semantic Swampista.
Data Lake -aikakaudella ongelmana oli ajatus: laitetaan kaikki data lakeen ja selvitetään myöhemmin, mitä sillä tehdään. Tuloksena oli usein data swamp.
Nyt vaarana on, että tehdään sama virhe kontekstin kanssa. Laitetaan AI lukemaan Slackit, Teamsit, sähköpostit, dokumentit, katalogit ja raportit ja oletetaan, että se rakentaa niistä automaattisesti yrityksen ontologian.
Mutta jos organisaation käsitteet ovat jo ristiriitaisia, AI voi yhtä hyvin automatisoida ristiriidan.
Myynti tarkoittaa asiakkaalla yhtä asiaa, talous toista ja asiakaspalvelu kolmatta. Kaikki voivat olla omassa kontekstissaan oikeassa. LLM voi kyllä löytää kaikki kolme määritelmää, mutta se ei tarkoita, että organisaatio olisi sopinut, mitä niistä käytetään missäkin tilanteessa.
Tästä pidän Joe Reisin ajatuksessa erityisesti: teknologia voi automatisoida kontekstin löytämisen, mutta se ei automaattisesti luo yhteistä ymmärrystä.
Jos governance puuttuu, Company Brain voi muuttua nopeasti Semantic Swampiksi.
Ja jälleen kerran joudumme toteamaan, että mukaan tarvitaan prosessit, päätökset, omistajuudet ja toimintamallit. Pelkkä teknologia ei tee tätä meidän puolestamme.
Ja sitten tulee yksityisyys
Pelkkä ajatuskin vähän puistattaa: ehdottaako joku oikeasti, että AI annettaisiin pääsy kaikkiin sähköposteihin ja Teams-keskusteluihin?
Tiedän. Ensimmäinen reaktio on helposti, että eihän tällainen voi mennä läpi. Tässä tulee vastaan tietosuoja, tietoturva, GDPR, työntekijöiden yksityisyys ja monta muuta ihan oikeaa kysymystä.
Toisaalta olen huomannut, että AI hyödyntämiselle asetetaan välillä aika paljon kovemmat standardit kuin niille järjestelmille, joita olemme käyttäneet jo vuosia.
Yksi tietoturva-asiantuntija sanoi minulle joskus aika osuvasti, että jos sähköposti keksittäisiin vasta nyt, sitä olisi ehkä aika vaikea saada läpi nykyisillä vaatimuksilla. Sähköposteissa käsitellään jatkuvasti henkilötietoja, joskus jopa terveystietoja ja muuta arkaluonteista sisältöä, ja silti sähköposti on täysin normaali osa yritysten toimintaa.
Tämä ei tietenkään tarkoita, että AI pitäisi vain avata kaikki viestit ja todeta, että “hyvin se menee”.
Päinvastoin. Jos sähköposteja, Teams-keskusteluja tai muuta viestintää käytetään AI kontekstina, pitää miettiä ainakin käyttöoikeudet, käyttötarkoitus, säilytysajat, työntekijöiden yksityisyys ja se, mikä tieto ylipäänsä kuuluu organisaation yhteiseen tietopohjaan.
Mutta minusta kiinnostava kysymys on myös tämä: asetammeko AI joskus niin korkean riman, että emme sallisi samalla logiikalla enää edes niitä järjestelmiä, joita jo käytämme joka päivä?
Ennen kuin tähän on olemassa oikeasti toimivia ratkaisuja, on kuitenkin aika monta kysymystä ratkaistavana. Osa on teknisiä ja juridisia, mutta osa myös moraalisia ja eettisiä: mikä tieto kuuluu organisaatiolle, mikä ihmiselle, mitä AI saa päätellä ja missä kulkee yksityisyyden raja.
Siihen asti on ehkä syytä hyväksyä, että suuri osa liiketoiminnan kontekstista ja määritelmistä syntyy edelleen ihmisten välisissä keskusteluissa. AI voi auttaa niiden tunnistamisessa ja dokumentoinnissa, mutta yhteinen ymmärrys ei synny ilman keskustelua.
Siksi puhun Context Governancesta
Tässä päädytään minusta vähän uuteen alueeseen.
Data Governance hallitsee dataa, määritelmiä, laatua ja omistajuuksia. Information Governance hallitsee dokumentteja, säilytysaikoja ja tietoa. Tietoturva hallitsee pääsyä, privacy henkilötietojen käyttöä ja AI Governance AI käyttöön liittyviä riskejä.
Mutta AI-agentin näkökulmasta nämä kaikki muodostavat yhden kokonaisuuden: kontekstin.
Agentin pitäisi tietää, mistä tieto tuli, kuka sen omistaa, kuinka tuoretta se on, onko se virallinen määritelmä vai Teamsissa heitetty idea, saako käyttäjä nähdä sen ja mitä määritelmää agentin pitäisi käyttää.
Ehkä juuri tätä pitäisi kutsua Context Governanceksi.
Ja siihen kuuluu myös hierarkia. Virallinen enterprise-tason KPI ei ole samalla tasolla kuin yksittäisen analyytikon Excel-kaava. Hyväksytty käsitemallin määritelmä ei ole samalla tasolla kuin Teams-kommentti. Sähköposti voi olla arvokas vihje siitä, että jotain on muuttunut, mutta se ei automaattisesti kumoa virallista määritelmää.
Company Brain tarvitsee siis muutakin kuin paljon tietoa. Se tarvitsee käsityksen siitä, mihin tietoon voi luottaa ja kuinka paljon.
Company Brain ei ole uusi järjestelmä
Siksi en lopulta ajattele Company Brainia yhtenä uutena teknologiana tai tietokantana. Se on enemmänkin tapa järjestää yrityksen olemassa oleva tieto ja konteksti niin, että myös AI pystyy käyttämään sitä.
Domainit omistavat omat merkityksensä. Käsitemallinnus tekee tärkeät käsitteet näkyviksi. Yhteiseen federated-malliin promotoidaan ne käsitteet ja KPI, joita muu organisaatio tarvitsee. Semantic Stewardin kaltainen rooli auttaa pitämään yhteisen merkityksen kasassa.
Governance syntyy mahdollisimman paljon samalla kun uusia ratkaisuja rakennetaan, ja AI voi auttaa tunnistamaan organisaation keskusteluista ja dokumenteista muutoksia, joita ihmisten pitäisi hyväksyä yhteiseen malliin.
Company Brainia ei siis rakenneta kerran. Sitä kasvatetaan samalla kun organisaatio tekee töitä, yksi domain, yksi case ja yksi uusi yhteinen määritelmä kerrallaan.
Ja ehkä juuri tämä on AI kannalta kaikkein tärkein muutos Data Governanceen: governancen pitäisi siirtyä yhä enemmän jälkikäteen tehtävästä dokumentoinnista osaksi sitä hetkeä, jolloin data, datatuote ja sen merkitys syntyvät.
Buzzword bingo
Hyvä lukija, kuten ehkä huomasit, tämä blogi on täynnä kaikenlaisia termejä: Company Brainia, semanttista kerrosta, federated-mallia, ontologiaa, Context Governancea ja ties mitä muuta.
I know. Tämä on aikamoinen buzzword-viidakko.
Ota nämä kuitenkin enemmän retorisina keinoina jäsentää ongelmaa kuin yrityksenä määritellä uusia virallisia termejä. Pahin mahdollinen lopputulos olisi, että käytämme seuraavat kaksi vuotta väittelemällä siitä, mitä semanttinen kerros oikeasti tarkoittaa.
Perusidea on lopulta aika yksinkertainen: yhdistetään liiketoiminnan ymmärrys dataan niin, että myös AI ymmärtää, mitä data tarkoittaa eikä ala sekoilla omiaan.
Lisälukemista
Meta Engineering: An Organizational Second Brain: Building an AI That Learns From Experts
https://engineering.fb.com/2026/09/02/ml-applications/organizational-second-brain-ai-learns-from-experts/
Joe Reis: This Year’s Better Mousetrap: New Tech, Same Old Problems, and The Semantic Swamp
https://joereis.substack.com/p/this-years-better-mousetrap-new-tech
Prashanth Subrahmanyam / Databricks: A Navigation Map for Your Organization’s Data: Genie One and Genie Ontology
https://www.linkedin.com/pulse/navigation-map-your-organizations-data-genie-one-subrahmanyam-gggcc/
Nan Li: From Meaning to Insights: Decoding the Data Modeling Map
https://nanalyticsmind.substack.com/p/from-meaning-to-insights-decoding
Tarvitsetteko puheenvuoron aiheesta?
Minua on viime aikoina pyydetty puhumaan semanttisesta kerroksesta ja sen roolista AI hyödyntämisessä.
Tarjoan nyt myös 30–60 minuutin puheenvuoroja aiheesta erityisesti organisaatioille, joissa halutaan saada liiketoiminta paremmin mukaan tekemiseen tai joissa semanttinen kerros nähdään vielä lähinnä teknologiaratkaisuna.
Puheenvuoro voidaan painottaa joko johdolle, datatiimille tai yhteiseksi keskustelunavaukseksi liiketoiminnan ja datan välille.
Hinta 500 € / 30–60 min.
Laita viestiä, jos aihe on teillä ajankohtainen.
Ystävällisin terveisin,
Johannes Hovi